로그인 기록은 어디까지 남겨야 하나
로그인 보안을 만들면서 IP를 어디에 저장할지, 무엇을 남길지, 그리고 그 기록을 언제 지울지 하나씩 결정했다.
며칠 전에는 해야 할 일이 계속 늘어나는 문제 때문에 작업 방식을 다시 정했다.
AI가 제안하는 기능을 순서대로 따라가지 않고, 한 영역을 정한 뒤 그 범위를 끝내고 다음으로 넘어가기로 했다.
먼저 정한 것은 사용자 관련 기능이었다.
남아 있던 일 가운데 하나가 로그인 보안 기록이었다.
사용자가 로그인했을 때 접속한 IP를 남기고, 이전과 다른 IP에서 로그인했는지 확인할 수 있도록 만드는 기능이었다.
처음 설명만 들으면 단순해 보였다.
로그인하면 IP를 기록한다.
새로운 IP인지 확인한다.
기록을 나중에 찾아볼 수 있게 한다.
그런데 실제로 만들려고 하니 바로 선택할 것이 생겼다.
AI는 로그인 기록을 별도의 공간에 쌓는 것과 함께, 사용자 정보에도 최근 로그인 IP를 저장하는 방법을 제안했다.
그리고 나에게 두 가지를 결정해 달라고 했다.
최근 IP를 사용자 정보에 따로 저장할 것인지.
그리고 로그인 기록을 얼마나 오래 보관할 것인지.
보관기간은 먼저 정했다.
30일.
로그인 이력을 계속 쌓아두는 것보다는 보안상 확인할 수 있는 기간을 두고, 오래된 기록은 자동으로 지우는 편이 낫다고 판단했다.
문제는 최근 IP였다.
처음에는 왜 같은 정보를 두 곳에 저장해야 하는지 이해되지 않았다.
로그인 기록이 따로 남는다면 그곳에서 가장 최근 기록을 찾아보면 되는 것 아닌가.
그래서 물었다.
“IP를 유저 문서에 저장하는 것과 안 하는 것의 차이점은 뭐지?”
AI는 최근 IP를 사용자 정보에 저장하면 새로 들어온 IP와 바로 비교할 수 있고, 저장하지 않으면 로그인 기록에서 마지막 값을 다시 찾아야 한다고 설명했다.
하지만 그것만으로는 결정하기 어려웠다.
개발 방식의 차이는 알겠는데, 내가 알고 싶은 것은 다른 것이었다.
그래서 사용자는 무엇이 달라지는가.
그리고 서비스를 운영하는 입장에서는 무엇이 달라지는가.
다시 설명해 달라고 했다.
최근 IP를 사용자 정보에 함께 저장하면 이전과 다른 IP에서 로그인했는지를 더 단순하게 판단할 수 있었다.
나중에 이상 로그인 알림 같은 기능을 붙일 때도 바로 최근 기록과 비교할 수 있다.
운영자가 특정 사용자의 최근 로그인 상태를 확인할 때도 별도의 로그인 기록을 뒤질 필요가 없다.
반대로 사용자 정보에 IP를 남기지 않으면 저장하는 개인정보는 줄어든다.
대신 최근 로그인 정보를 확인해야 할 때마다 별도로 쌓인 기록에서 마지막 데이터를 찾아야 한다.
기능을 만들 수 없는 것은 아니었다.
다만 같은 기능을 제공하는 데 한 단계를 더 거쳐야 했다.
그제야 선택지가 이해됐다.
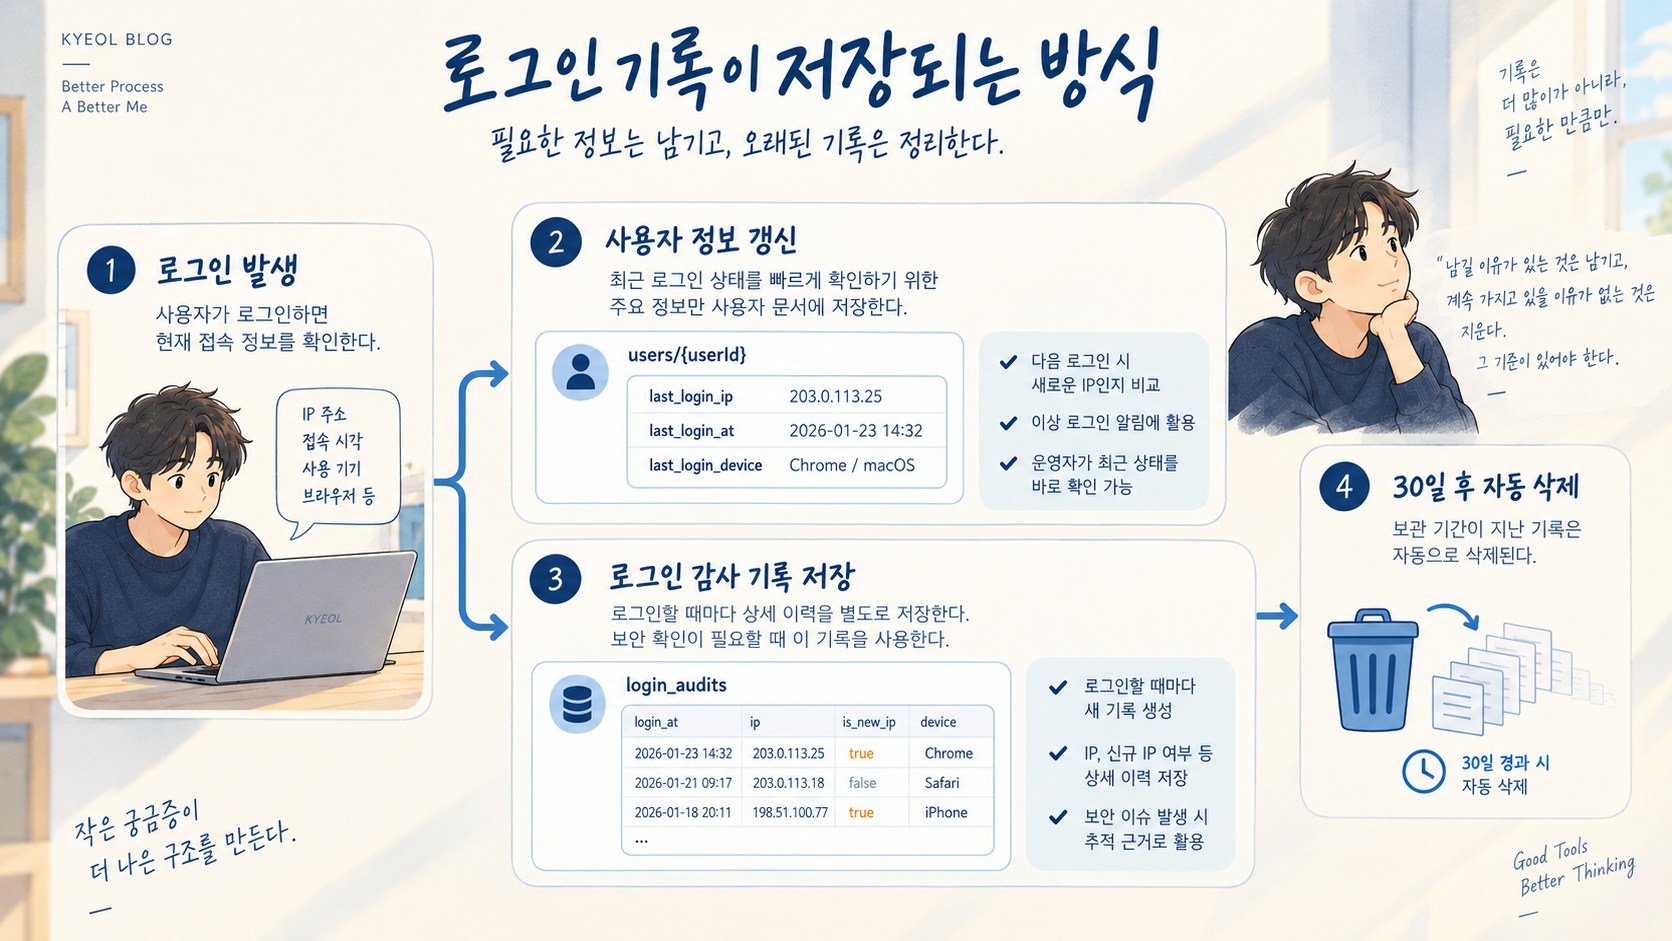
나는 최근 로그인 IP를 사용자 정보에도 저장하기로 했다.
대신 로그인할 때마다 생기는 상세 기록은 별도의 로그인 감사 기록으로 분리했다.
사용자 정보에는 최근 상태를 확인하기 위한 값이 남고,
별도 기록에는 로그인할 때마다 접속 IP와 새로운 IP인지 여부 같은 이력이 쌓인다.
그리고 그 이력은 30일이 지나면 자동으로 삭제한다.
처음에는 ‘로그인 IP를 기록하는 기능 하나’였는데, 실제로는 세 가지 기준을 정하는 일이었다.
무엇을 저장할 것인가.
어디에 저장할 것인가.
얼마 동안 남겨둘 것인가.
그 기준이 정해진 다음에야 코드 작업으로 넘어갔다.
로그인할 때 현재 IP를 확인하고, 이전 IP와 비교하고, 로그인 기록을 남기고, 사용자 정보의 최근 IP를 갱신하도록 만들었다.
오래된 기록을 정리하는 작업도 함께 넣었다.
나는 코드를 만든 뒤 다시 AI에게 검수를 요청했다.
전날 정했던 작업 방식도 그대로 유지했다.
AI가 설계 방향을 설명하고,
내가 필요한 차이를 이해한 뒤 결정하고,
코드를 만든 다음,
다시 AI에게 검수를 맡긴다.
이번에는 특히 그 과정이 필요했다.
‘보안이니까 많이 기록해두면 좋다’는 식으로 결정했다면 어떤 데이터가 왜 남는지 나도 설명하기 어려웠을 것이다.
반대로 개인정보를 줄인다는 이유만으로 아무것도 저장하지 않으면 만들려던 보안 기능 자체가 복잡해질 수 있었다.
그래서 기능 이름보다 먼저 실제 사용 상황을 물어봤다.
사용자가 느끼는 차이는 무엇인지.
운영할 때 어떤 차이가 생기는지.
그 차이를 알고 나니 저장할지 말지를 내가 결정할 수 있었다.
나는 개발자가 아니기 때문에 처음부터 어떤 데이터 구조가 가장 좋은지 알 수는 없다.
하지만 두 방식이 실제 서비스에서 어떻게 달라지는지 설명을 들으면 선택은 할 수 있다.
오히려 그 선택을 하지 않은 채 구현부터 시작하면, 나중에는 왜 그런 구조가 만들어졌는지 알기 어려워진다.
지난번에는 AI가 제안하는 일이 계속 늘어나는 것을 보면서 먼저 범위를 정해야 한다는 것을 확인했다.
이번에는 그 범위 안에서도 같은 원칙이 필요했다.
AI가 필요한 필드를 제안했다고 바로 추가하지 않는다.
왜 필요한지 묻고,
사용자와 운영에서 무엇이 달라지는지 확인하고,
얼마나 보관할지도 정한다.
그다음에 만든다.
보안 기능을 하나 추가한 날이었지만, 실제로 내가 정한 것은 기능보다 기록의 경계에 가까웠다.
남길 이유가 있는 것은 남긴다.
계속 가지고 있을 이유가 없는 것은 지운다.
그리고 그 이유를 이해한 뒤 코드로 옮긴다.
그날의 성장 노트
남은 생각 · 데이터를 저장할 수 있다는 것과 계속 저장해야 한다는 것은 다르다. 이후 다른 로그를 만들 때도 무엇을 남길지뿐 아니라 언제 지울지까지 함께 정할 필요가 있다.
그때의 기준 · 데이터 구조를 결정할 때 구현 방식만 듣고 선택하지 않는다. 사용자와 운영에서 무엇이 달라지는지 확인한 뒤 저장 위치와 보관기간을 결정한다.
글을 읽고 함께 이야기하고 싶은 일이 생겼다면.
결을 같이 하기